Développement de logiciels multilingues
Vos clients, vos équipes et vos partenaires travaillent dans plusieurs langues. Votre logiciel doit suivre dès la première version, pas après un rattrapage coûteux. En Belgique, trois langues sont officielles (néerlandais, français, allemand) : une PME wallonne ou bruxelloise vend couramment en Flandre, aux Pays-Bas et en France. Pour une entreprise française, le marché voisin le plus proche ne parle déjà plus seulement français. Un logiciel monolingue bute sur le marché intérieur, pas seulement à l'export. Globaprom construit des applications web, des portails et des automatisations multilingues dès le premier commit : architecture internationalisée, données propres en Unicode, et chaînes de traduction branchées sur des flux professionnels.
Nous avons dirigé une entreprise de traduction pendant plus de 20 ans avant de proposer des services de développement logiciel sur mesure. Le multilingue n'est pas une option que nous greffons après coup. C'est notre façon de construire, avec un périmètre fixe, un prix fixe et une date de livraison en semaines.
Pourquoi la plupart des logiciels échouent à l'international (le piège du rattrapage)
La plupart des logiciels échouent hors de leur marché d'origine pour une seule raison : ils ont été conçus dans une langue et traduits après coup. Les mots ne sont que la couche visible. Dessous, on trouve des chaînes codées en dur, des mises en page calibrées pour des libellés courts, une logique de dates qui suppose une seule convention de calendrier, et une base de données qui stocke du texte sans savoir quelle écriture il contient.
Cela vous coûte des ventes. L'étude « Can't Read, Won't Buy » de CSA Research, menée auprès de 8 709 consommateurs dans 29 pays, a établi que 76 % préfèrent acheter des produits présentés dans leur langue, et que 40 % n'achèteront jamais sur des sites dans une autre langue. Moins de 20 % de la population mondiale parle anglais, alors que près de la moitié des sites web sont rédigés dans cette langue (Statista, 2026). Un produit disponible dans une seule langue se dispute une minorité de son marché.
Le rattrapage est la solution la plus chère. Ajouter des langues à une base de code monolingue oblige à toucher toutes les couches à la fois (chaînes d'interface, validation, e-mails, PDF, champs de base de données, recherche) pendant que le produit continue d'évoluer. Les équipes rapportent un effort d'ingénierie deux à cinq fois supérieur pour un rattrapage que pour le même support intégré dès le départ (XTM, 2026). La plupart découvrent en cours de projet qu'elles avaient budgété de la traduction et acheté de la réingénierie.
Nous croisons les mêmes défaillances si souvent que nous les avons répertoriées : pourquoi les logiciels échouent à l'international détaille les sept erreurs que nous rencontrons le plus, et ce que chacune coûte à corriger.
Internationalisation (i18n), localisation (l10n) et traduction
En rendez-vous commercial, ces trois termes s'emploient les uns pour les autres. Sur une facture, ce sont trois postes distincts, et les confondre fait dérailler les budgets.
- L'internationalisation (i18n) relève de l'ingénierie. L'abréviation compte les 18 lettres entre le « i » et le « n ». Elle rend le logiciel capable de gérer n'importe quelle langue, région ou format sans modifier le code : textes externalisés, données sûres côté encodage, logique adaptée aux locales. Elle se fait une fois, et chaque marché futur en profite.
- La localisation (l10n) adapte le produit à un marché précis : la traduction de l'interface, mais aussi les formats, les images, les mentions légales, les moyens de paiement et le ton.
- La traduction est une tâche au sein de la localisation : faire passer un texte d'une langue à une autre.
L'ordre compte. L'internationalisation sert de fondation, la localisation se répète par marché au-dessus, et la traduction reste un coût de contenu récurrent. Faites l'impasse sur la première, et chaque nouveau marché repaie le prix du rattrapage.
Pour le versant ingénierie en langage clair, lisez l'internationalisation logicielle expliquée aux non-ingénieurs. Pour comprendre pourquoi les deux se chiffrent séparément, voir localisation ou traduction. Nous avons facturé des deux côtés de cette ligne pendant vingt ans.
Architecture i18n : quoi intégrer dès le premier jour
Une architecture multilingue dès la conception tient en une courte liste de décisions concrètes. Prises au départ, chacune coûte peu. Rattrapées plus tard, chacune coûte cher. Voici ce que contient chaque projet que nous livrons :
- Unicode partout. Unicode attribue un point de code à chaque caractère de chaque système d'écriture, et UTF-8 en est l'encodage dominant. Chaque colonne de base de données, API, export de fichier et modèle d'e-mail que nous construisons est en UTF-8 de bout en bout, car un seul composant hérité avec un autre encodage suffit à corrompre noms et adresses. Ce texte illisible porte un nom, le « mojibake », et nous le décortiquons dans Unicode dans les applications métier.
- Chaînes externalisées. Aucun texte visible par l'utilisateur ne vit dans le code. Chaque libellé, message d'erreur et e-mail se trouve dans des fichiers de ressources à clés stables, prêts pour les traducteurs. Les phrases ne sont jamais assemblées à partir de fragments, car l'ordre des mots change d'une langue à l'autre.
- Formatage de messages ICU. ICU (International Components for Unicode) est la bibliothèque open source qui gère pluriels, genre, listes et valeurs formatées selon la langue. L'anglais a deux formes de pluriel, l'arabe en a six, et en polonais la règle change selon le nombre lui-même. Des gabarits de chaînes n'y suffisent pas. ICU, si.
- Données de locales CLDR. Le CLDR (Common Locale Data Repository, maintenu par le Consortium Unicode) fournit les données de chaque locale, c'est-à-dire d'une combinaison langue-région comme fr-BE : formats de date, séparateurs numériques, symboles monétaires, ordres de tri. Nous l'utilisons plutôt que des tables de formats tenues à la main.
- Un modèle de données traduisible. Les chaînes d'interface ne sont que la moitié du problème. Noms de produits, catégories, modèles de documents et notifications vivent dans la base de données, donc le schéma les stocke par langue dès le premier jour, en général derrière un CMS multilingue ou des champs de contenu localisés.
- hreflang et routage par locale. hreflang est l'annotation HTML qui indique aux moteurs de recherche quelle version linguistique d'une page afficher à chaque utilisateur. Nous la générons à partir de la configuration des locales, jamais à la main.
- Pseudo-localisation en CI. La pseudo-localisation remplace le texte par des chaînes factices accentuées et rallongées, comme « [!!! Àççôûñt Šéttîñgš !!!] », pour débusquer les textes codés en dur et les mises en page qui cassent avant qu'un seul mot ne soit traduit.
Le reste de nos pratiques est rassemblé dans les bonnes pratiques des applications mondiales. Sur votre projet, les critères d'acceptation i18n qui les imposent sont inscrits dans le périmètre fixe.
RTL, CJC et les écritures qui cassent les interfaces naïves
Deux familles d'écritures révèlent une internationalisation fragile plus vite que tout le reste. Repérez les problèmes en test, et vos utilisateurs ne les verront jamais.
Les écritures de droite à gauche (RTL), l'arabe et l'hébreu, inversent le sens de lecture de toute l'interface. Une vraie prise en charge RTL suppose des mises en page en miroir (navigation, icônes, parcours de progression), des propriétés CSS logiques plutôt que des valeurs gauche/droite, et un texte bidirectionnel correct, quand une phrase arabe contient un code produit latin ou un numéro de téléphone qui se lit dans l'autre sens. Une interface naïve transforme le texte RTL en bouillie visuelle, et les utilisateurs le remarquent en quelques secondes.
Les écritures CJC (chinois, japonais, coréen) cassent d'autres hypothèses. Pas d'espaces entre les mots : le retour à la ligne doit connaître l'écriture. Des caractères plus denses : les tailles de police et les interlignes réglés pour l'alphabet latin deviennent illisibles. La recherche, le tri et les méthodes de saisie se comportent aussi autrement.
Reste l'expansion du texte. Les libellés allemands sont environ 30 % plus longs que l'anglais, et même des mots courants débordent des boutons à largeur fixe. Les mises en page doivent être testées avec de vraies écritures, pas traduites en dernier : chaque projet multilingue que nous livrons passe la pseudo-localisation plus au moins une locale RTL et une locale CJC.
Multidevise, dates, nombres et formats : les détails qui érodent la confiance
Les erreurs de format produisent rarement des rapports de bug. Elles produisent une méfiance silencieuse, l'impression qu'un produit a été conçu pour ailleurs. Soignez-les, et votre logiciel paraît local sur chaque marché où vous vendez.
- Devise. Une tarification multidevise, ce sont des prix par marché avec des arrondis maîtrisés, pas une conversion au taux du jour au moment de l'affichage. Il faut aussi respecter les unités mineures : le yen japonais n'a pas de décimales, et certaines devises en utilisent trois. Stockage, arrondi et règles d'affichage sont détaillés dans la gestion multidevise dans les logiciels.
- Dates et heures. 04/07/2026, c'est juillet à Bruxelles et avril à New York. Nous affichons les dates selon la locale à partir des modèles CLDR et stockons les horodatages en UTC avec fuseau explicite, une habitude qui garde aussi le reporting transfrontalier fiable.
- Nombres. 1.500 vaut quinze cents à Berlin, et un et demi pour un système américain. Les séparateurs décimaux et de milliers doivent suivre la locale à l'affichage comme à la saisie, sinon un import corrompt des données financières sans bruit.
- Noms et adresses. Ordre des noms, civilités, formats postaux et conventions téléphoniques varient selon le marché. Un formulaire qui impose une structure américaine refuse des clients parfaitement valides.
Chaque détail est minime. Ensemble, ils décident si un acheteur belge, un dispatcheur saoudien ou un technicien d'usine japonais considère le logiciel comme le sien.
Pipelines de traduction : relier votre application à des flux de traduction professionnels
Ici, nous jouons à domicile. Un pipeline de traduction est le trajet automatisé que suit votre contenu, de la base de code jusqu'aux traducteurs, puis en retour. C'est lui qui garde un logiciel multilingue à jour, version après version, au lieu d'une traduction unique qui vieillit.
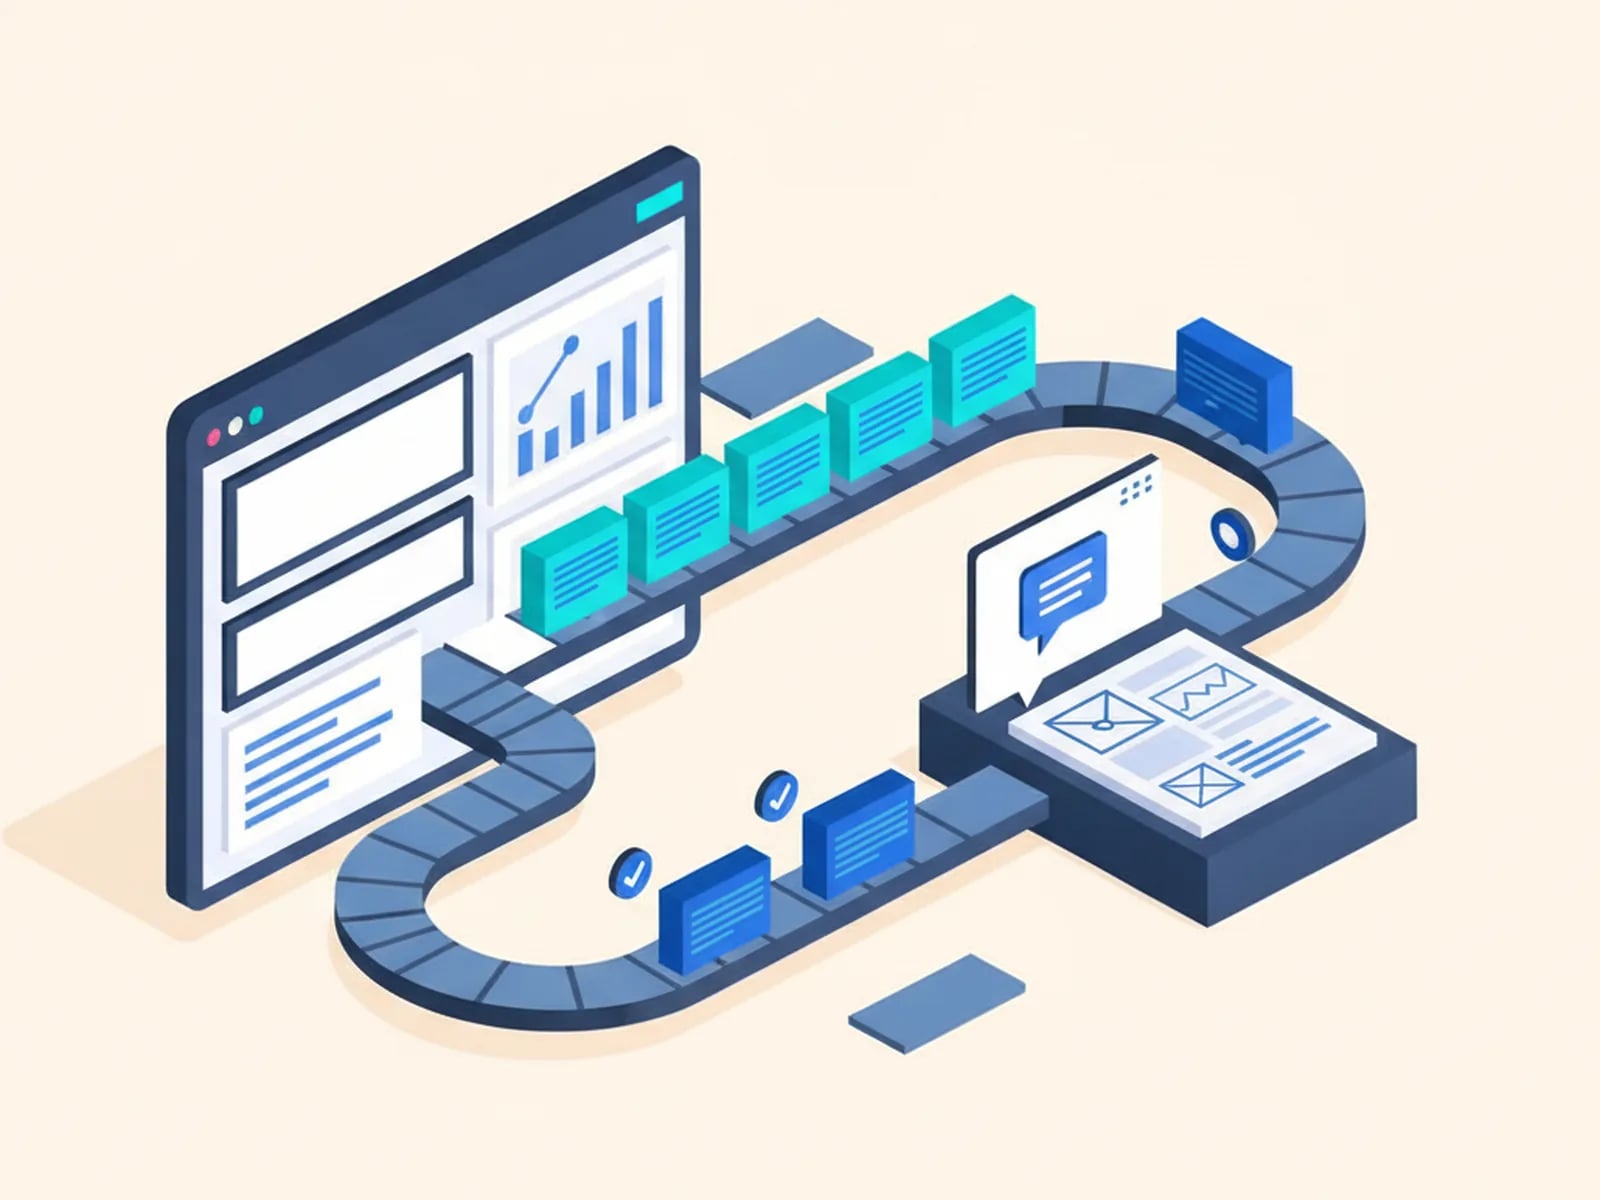
Un pipeline de production compte cinq étapes :
- Extraction. Les chaînes nouvelles ou modifiées sont détectées automatiquement à chaque version. Plus personne n'envoie de tableurs par e-mail.
- Transmission au TMS. Un système de gestion de traduction (TMS) répartit le contenu entre traducteurs et suit l'avancement. Il applique la mémoire de traduction (des traductions déjà validées, réutilisées au lieu d'être payées deux fois) et des glossaires terminologiques, pour que le vocabulaire de votre produit reste cohérent d'une version et d'une langue à l'autre.
- Traduction. Traducteurs humains, traduction automatique, ou post-édition de traduction automatique (MTPE : une traduction automatique relue et corrigée par un professionnel), selon le type de contenu. Textes juridiques et chaînes d'interface méritent un soin humain. Les descriptions de catalogue en volume justifient souvent la MTPE.
- Relecture en contexte. Les traducteurs voient les chaînes là où elles s'affichent, pas dans une colonne de tableur. La plupart des défauts de traduction sont des défauts de contexte.
- Fusion et déploiement. Les traductions validées passent par les mêmes contrôles de relecture que le code. Avec la localisation continue, la boucle tourne à chaque version, et aucune langue n'attend jamais une « phase de traduction ».
Nous avons fait tourner ce type de flux sur des dizaines de paires de langues pendant plus de 20 ans, en tant que prestataire de traduction, en coordonnant des centaines de linguistes professionnels sous délais fermes. Choix d'outils et architecture complète : notre guide des pipelines de traduction.
Comment nous construisons multilingue d'abord : l'héritage comme preuve
Globaprom est né de BeTranslated, une entreprise de traduction internationale que nous avons fondée et que nous dirigeons toujours (l'histoire derrière Globaprom). Cet héritage se voit dans le travail que nous vous livrons, de façon précise et vérifiable :
- Nous avons été notre propre premier client. Nos systèmes multilingues de facturation, de devis et de portail fournisseurs ont été construits pour nos propres opérations de traduction : multidevise, multi-locale, et en production pendant des années avant que nous vendions le moindre projet.
- Les locales se cadrent, elles ne se supposent pas. Chaque projet démarre par une matrice de locales : quelles langues, écritures, devises et formats il vous faut aujourd'hui, et lesquels vous faudront sans doute demain. Les critères d'acceptation i18n entrent dans le périmètre fixe.
- La vitesse de l'IA, la qualité d'une relecture humaine. Nous construisons avec le développement assisté par IA. Le code généré retombe par défaut sur des hypothèses anglophones si le pipeline ne l'interdit pas : c'est pourquoi la relecture de code et des tests de pseudo-localisation en CI imposent la checklist i18n ci-dessus.
- Vous n'avez pas à organiser la traduction. Grâce à notre réseau de linguistes professionnels, nous connectons votre TMS, organisons la traduction humaine ou la MTPE, et vous remettons un pipeline qui tourne, pas un dossier de chaînes accompagné de vœux pieux.
Peu d'agences de logiciel sur mesure peuvent avancer ces quatre arguments à la fois. C'est pour cela que nous commençons par eux.
Logiciels multilingues par secteur
Chaque secteur a ses points de friction multilingues, et chacune de nos pratiques sectorielles les prend en charge d'office :
- Logistique. Documents douaniers, applications chauffeurs multilingues et portails partenaires pour le fret transfrontalier, au cœur de notre travail en logiciel logistique sur mesure.
- E-commerce et retail. Boutiques localisées, catalogues multilingues et systèmes PIM reliés à la traduction. Voir le développement e-commerce sur mesure.
- Industrie et service terrain. Instructions de travail numériques traduites et applications d'inspection pour des usines internationales et des équipes aux langues variées. Voir les logiciels sur mesure pour l'industrie et le service terrain.
- Équipes IT. Portails collaborateurs et outils d'administration pour des équipes réparties, dans le cadre de nos outils internes sur mesure et automatisation IT, et sujet de notre guide des logiciels pour équipes internationales.
- Petites entreprises. Outils de facturation et de devis multidevises qui permettent à une société de cinq personnes de servir des clients dans trois pays. Voir le logiciel sur mesure pour PME.
Quel que soit votre secteur, les langues dont vous avez besoin sont inscrites dans le périmètre fixe dès le départ.
Étude de cas : la livraison multilingue en pratique
C21 Perdomo : site web multilingue et système de suivi. Pour cette agence immobilière, nous avons construit un nouveau site multilingue, développé avec l'aide de l'IA, doté d'un système de suivi intégré et internationalisé dès le premier commit plutôt que rattrapé. Contenus adaptés à chaque locale et interface multilingue sont passés en production comme un seul système cohérent.
D'autres projets sont présentés dans nos études de cas.
Questions fréquentes sur les logiciels multilingues
Qu'est-ce que le développement de logiciels multilingues ?
Le développement de logiciels multilingues consiste à construire des applications qui fonctionnent correctement dans plusieurs langues, écritures et formats régionaux. Il combine l'internationalisation (i18n), l'ingénierie qui rend toute langue possible, avec la localisation (l10n) et les flux de traduction qui livrent la version de chaque marché.
Quelle est la différence entre internationalisation et localisation ?
L'internationalisation (i18n) est une ingénierie réalisée une fois, qui rend le logiciel capable de prendre en charge n'importe quelle langue : chaînes externalisées, données Unicode, formatage adapté aux locales. La localisation (l10n) est le travail par marché au-dessus : traduire le contenu et adapter formats, devises et conventions pour un public précis.
Construire multilingue dès le premier jour coûte-t-il plus cher ?
Marginalement, oui : chaînes externalisées, discipline UTF-8 et formatage par locale ajoutent peu quand ils sont prévus dès le départ. Rattraper la même capacité plus tard impose de retravailler chaque couche d'un produit en ligne, pour un effort d'ingénierie deux à cinq fois supérieur (XTM, 2026).
Pouvez-vous ajouter des langues à un logiciel existant ?
Oui. Nous internationalisons les bases de code existantes par étapes : audit de l'encodage et des chaînes codées en dur, externalisation des textes, correction de la logique de formatage, puis branchement d'un pipeline de traduction. L'audit vient en premier, parce que la réponse honnête sur l'effort dépend de la profondeur des hypothèses anglophones.
Comment les mises à jour de traduction arrivent-elles dans le logiciel ?
Par un pipeline de traduction. Les chaînes nouvelles et modifiées sont extraites automatiquement, routées vers un système de gestion de traduction (TMS), traduites par des humains ou en post-édition de traduction automatique (MTPE), relues en contexte, puis fusionnées à chaque release. Pas de tableurs, pas de langues périmées.
Traduisez-vous le contenu vous-mêmes ?
Nous l'organisons. Globaprom est né d'une entreprise de traduction forte de plus de 20 ans d'activité sur des dizaines de paires de langues, alors nous connectons votre produit à des linguistes professionnels via le pipeline que nous construisons. Vous choisissez traduction humaine, MTPE, ou un mélange par type de contenu.
Construisez-le une fois, vendez-le partout
Dites-nous quels marchés votre logiciel doit servir : langues, écritures et devises. Vous recevez un périmètre fixe, un prix fixe et une date de livraison en semaines, avec le pipeline de traduction prévu dans le plan et le code à vous à la remise.