Pipelines de traduction : de l'extraction au déploiement continu
Un pipeline de traduction achemine le contenu du code à la mise en ligne : extraction, TMS, traduction humaine ou MTPE, relecture et déploiement.
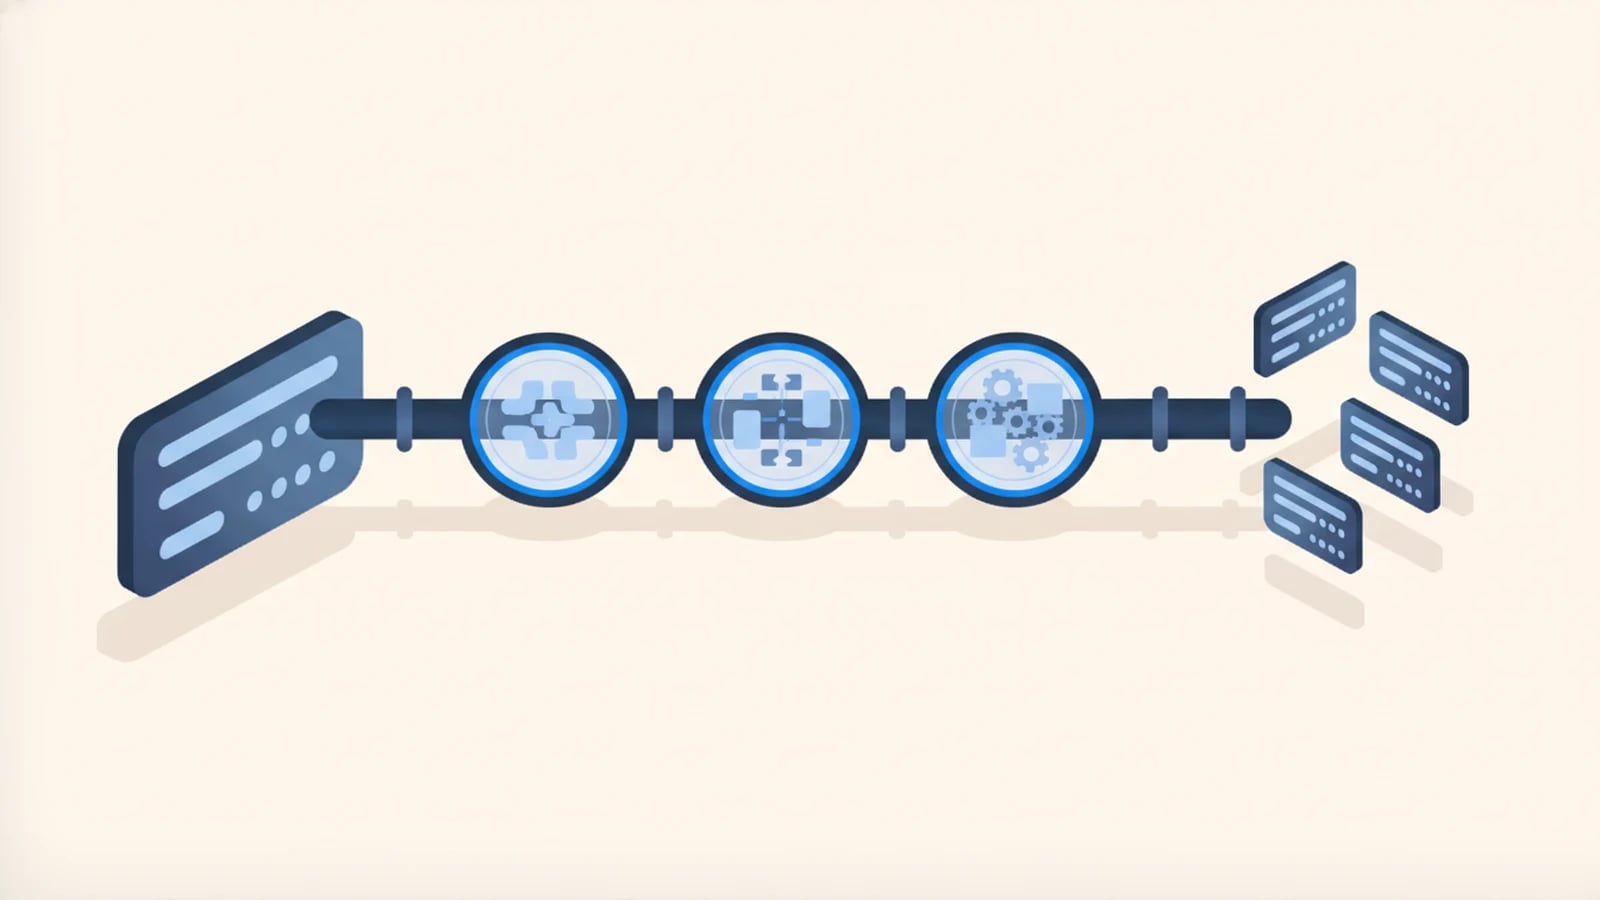
Un pipeline de traduction est le parcours automatisé que suit le texte de votre produit, depuis la base de code jusqu’aux traducteurs professionnels, puis de retour en production à chaque version. Plus besoin de feuilles de calcul ni de fils d’e-mails pour transmettre manuellement le travail. L’internationalisation désigne la conception et le développement d’un produit conçu pour être localisé, notamment en séparant les éléments traduisibles du code source (W3C), et un pipeline de traduction s’appuie sur cette base. C’est l’infrastructure du développement logiciel multilingue : elle détermine si une nouvelle fonctionnalité sort dans toutes les langues prises en charge dès le premier jour. Sans lui, il faut parfois attendre des semaines une tournée de traduction manuelle, pendant que tous les marchés hors de votre langue d’origine prennent du retard.
Nous avons d’abord conçu cette architecture côté prestataire, au sein de BeTranslated, l’entreprise de traduction dont Globaprom est issue : nous y avons coordonné des centaines de linguistes professionnels sur des dizaines de paires de langues, sous des délais clients stricts, pendant plus de vingt ans.
Capturer chaque nouvelle chaîne à chaque version
L’extraction est la première étape, et elle peut être automatisée si elle est bien intégrée au processus de build. Un script ou un plugin analyse la base de code à chaque commit ou version, repère les chaînes visibles par l’utilisateur et les compare à la dernière version connue, à condition que le périmètre soit clairement défini et que les erreurs d’extraction soient maîtrisées. Les nouvelles chaînes sont marquées comme telles, les chaînes modifiées sont signalées comme modifiées, et non pas renvoyées en silence comme du contenu neuf jamais traduit. Les chaînes supprimées sortent du périmètre, évitant ainsi aux traducteurs de perdre du temps sur un texte qui ne sera plus utilisé.
La méthode varie selon la pile technique. Les projets React et Vue extraient généralement les chaînes depuis des fichiers de ressources i18next ou FormatJS. Les applications rendues côté serveur utilisent des fichiers gettext .po ou des bundles de ressources Java. Les sites statiques les puisent dans le front matter et le contenu Markdown. Chaque configuration repose sur la même règle, issue de la couche i18n : les chaînes sont stockées dans des fichiers de ressources sous des clés stables, jamais assemblées dynamiquement dans la logique applicative. Un pipeline ne peut extraire que ce que l’architecture a déjà externalisé. Ignorez cette base (voir l'i18n expliquée aux non-ingénieurs) et il ne restera rien à extraire proprement, seulement des chaînes enfouies dans le code, inaccessibles sans risque pour un script.
Cette étape évite un problème familier à quiconque a géré du contenu multilingue à l’ancienne. Un développeur livre une fonctionnalité, la chaîne française apparaît, et les autres langues dérivent en silence jusqu’à ce que quelqu’un se souvienne de lancer une traduction. L’extraction automatisée supprime ce besoin de mémoire : dès qu’une chaîne existe dans la langue source, elle entre dans la file d’attente de toutes les autres langues.
Mémoire de traduction et glossaires terminologiques : l’atout du TMS
Les chaînes extraites sont envoyées vers un système de gestion de traduction (TMS), la plateforme qui achemine le contenu vers les traducteurs, suit l’avancement par langue et applique deux mécanismes clés pour rendre la traduction répétée à la fois économique et cohérente.
La mémoire de traduction est une base de données qui stocke chaque segment déjà traduit et le compare au nouveau contenu, phrase par phrase. Une chaîne identique à une traduction existante peut être réutilisée à moindre coût, voire gratuitement selon le contrat et le TMS. Une chaîne proche mais non identique (une « correspondance partielle » ou fuzzy match) est proposée au traducteur avec le pourcentage de différence affiché, pour qu’il l’adapte plutôt que de tout retaper. Au fil des années, la mémoire de traduction se bonifie : les chaînes d’interface récurrentes, les textes juridiques standardisés et les noms de produits répétés coûtent bien moins cher à retraduire, sans pour autant se passer d’un contrôle humain.
Les glossaires terminologiques résolvent un autre enjeu : la cohérence. Sans eux, un produit français avec des dizaines de contributeurs et des centaines de chaînes accumulera inévitablement trois termes néerlandais différents pour le même bouton, car trois traducteurs auront chacun fait un choix logique à trois jours d’intervalle. Un glossaire verrouille le terme approuvé, sa catégorie grammaticale, son contexte et les termes à éviter, pour que chaque traducteur, humain ou machine, traduise « panier » de la même façon sur chaque écran. Nous gérons les glossaires clients comme nous l’avons fait pendant deux décennies pour nos clients traducteurs : relus par quelqu’un qui connaît le produit, et non générés une fois au lancement puis abandonnés.
La plupart des plateformes TMS utilisent le format XLIFF, le XML Localization Interchange File Format, standardisé par OASIS précisément pour transporter le contenu traduisible, son contexte et son statut d’un outil à l’autre sans perte. Le comité technique OASIS XLIFF définit XLIFF comme un format XML destiné à l’échange, entre outils, d’objets logiciels et documentaires localisables ainsi que de leurs métadonnées associées. Un TMS incapable d’importer et d’exporter correctement du XLIFF se heurtera à votre base de code à chaque passage de relais, et pas seulement lors de la première intégration.
Traduction humaine, automatique ou MTPE : adapter la méthode au contenu
Toutes les chaînes ne méritent pas la même approche. Les traiter de manière uniforme gaspille soit l’argent, soit la qualité, souvent les deux.
La traduction humaine justifie son coût là où une erreur serait coûteuse : clauses contractuelles, pages de tarifs, mentions légales, textes d’onboarding qui façonnent la première impression, ou toute chaîne sur un écran de paiement ou de consentement. Un linguiste expérimenté repère l’ambiguïté qu’une machine traduit avec assurance… et à côté.
La post-édition de traduction automatique (MTPE) occupe un terrain intermédiaire. Un moteur de traduction automatique génère une première version, qu’un traducteur professionnel relit et corrige en s’appuyant sur le texte source, plutôt que de partir d’une page blanche. La norme ISO 18587:2017, Services de traduction, Post-édition de texte issu de traduction automatique (exigences) fixe les exigences pour le processus de post-édition humaine complète d’un texte issu de traduction automatique, ainsi que les compétences requises pour les post-éditeurs. Elle s’applique spécifiquement au contenu traité par des systèmes de traduction automatique, ce qui est crucial car le terme « MTPE » est souvent utilisé de manière floue dans les argumentaires commerciaux. La norme définit ce qu’une post-édition complète doit réellement vérifier avant livraison. La MTPE convient aux volumes qu’un budget purement humain ne pourrait absorber : descriptions de produits en longue traîne, archives de support ou catalogues comptant des milliers d’entrées quasi identiques.
La traduction automatique brute, sans relecture, a sa place sur une part étroite du contenu : nous la réservons à des outils internes invisibles hors de l’entreprise, ou à des textes explicitement signalés comme générés par machine, pour que le lecteur sache à quoi s’en tenir. Nous la recommandons rarement pour un contenu en contact avec les clients sans au moins une relecture humaine légère : un texte fluide mais inexact peut être plus difficile à repérer qu’une coquille évidente.
Cette décision gagne en efficacité lorsqu’elle est formalisée sous forme de carte par type de contenu, définie une fois pour toutes par projet plutôt que débattue pour chaque chaîne. Nous l’intégrons directement dans les règles de routage du TMS dès la mise en place, pour que le nouveau contenu atterrisse automatiquement sur le bon bureau, sans réunion de tri.
Pourquoi la relecture en contexte évite ce que les feuilles de calcul ne voient pas
Une chaîne traduite correctement en isolation peut s’avérer fausse à l’écran. Le mot « Commande » désigne un achat sur une boutique et une instruction dans un outil technique, et le néerlandais distingue bestelling et opdracht : deux termes sans rapport, pour une seule ligne de tableur qui n’en dit rien. « Solde », « Note » ou « Support » posent le même piège, et un traducteur qui ne voit que la colonne source joue aux devinettes. La longueur est un autre écueil fréquent : un libellé qui tient au millimètre dans un bouton en français peut déborder une fois traduit en allemand. Pour les textes anglais très courts (jusqu’à dix caractères), le W3C indique une expansion moyenne pouvant atteindre 200 à 300 % à la traduction, et recommande une mise en page flexible (W3C, La taille des textes dans les traductions).
La relecture en contexte comble cette lacune. Les plateformes TMS modernes affichent un aperçu réel ou simulé de l’écran concerné, permettant aux traducteurs de voir le bouton, les libellés adjacents et l’espace disponible pendant leur travail, et non un simple numéro de ligne à côté d’un identifiant de chaîne. Certaines configurations vont plus loin en associant à chaque chaîne des captures d’écran automatiques prises sur un environnement de préproduction.
Nous considérons cette étape comme obligatoire, car l’écart de qualité est trop important pour être ignoré. Un traducteur sans contexte devine, et chaque supposition est un pari contre le sens réel de votre produit. La relecture en contexte vise précisément à repérer les problèmes de sens et d’affichage invisibles dans une simple liste de segments : le traducteur travaille sur le produit qu’il a sous les yeux, et non sur une liste de mots isolés.
Fusion et déploiement continus : en finir avec la « phase de traduction »
L’ancien modèle traitait la traduction comme une phase distincte : on construisait le produit en français, on gelait les chaînes, on envoyait un lot aux traducteurs, on attendait, puis on livrait toutes les langues d’un coup, généralement des semaines après la version française. Chaque mise à jour répétait ce cycle gel-attente, laissant les utilisateurs néerlandophones, allemands ou espagnols en permanence à la traîne, rattrapant une version déjà sortie et souvent dépassée.
Un pipeline de production remplace cette phase par une boucle. Les traductions validées reviennent du TMS via les mêmes processus de relecture et de build que le code : une pull request, des vérifications automatisées, une fusion. Avec la localisation continue, cette boucle s’exécute à chaque version plutôt que selon un calendrier de traduction séparé, si bien qu’un utilisateur néerlandais ou japonais découvre une nouvelle fonctionnalité dans la même fenêtre de publication que la version française, et non un trimestre plus tard.
C’est cette bascule qui distingue un logiciel multilingue toujours à jour d’un produit traduit une fois puis abandonné. Nous avons pratiqué les deux modèles côté prestataire : l’ancien passage de relais par lots, où l’équipe d’ingénierie d’un client dépendait de notre calendrier de livraison, et la boucle continue, où le contenu traduit fusionne aux côtés du code parce que le pipeline le traite comme un artefact de build, et non comme un workflow parallèle géré sur son propre rythme. Le second modèle élimine toute une catégorie de réunions de suivi « quelle langue est en retard ? ». La réponse est toujours la même : aucune.
Ce que vingt ans côté prestataire nous ont appris
Nous étions autrefois à l’autre extrémité de ce pipeline, et non dans l’entreprise qui le construit. Pendant plus de deux décennies, BeTranslated a reçu des chaînes extraites, mobilisé des centaines de linguistes indépendants sur des dizaines de paires de langues, et renvoyé les traductions finalisées selon le délai du client, et non le nôtre.
Cette expérience nous a montré où les pipelines échouent vraiment. Les glossaires se dégradent dès que personne n’en assume la responsabilité après la réunion de lancement. La mémoire de traduction se dégrade si une migration de TMS en perd la base, et chaque chaîne est alors refacturée comme neuve. Les délais glissent, comme nous l’avons observé, surtout aux points de passage plutôt que pendant la traduction elle-même : un linguiste ne peut commencer que lorsque le contenu lui parvient dans un format exploitable.
Construire aujourd’hui le pipeline nous-mêmes, plutôt que de recevoir des fichiers à son extrémité, explique pourquoi nous concevons d’abord le passage de relais : quel TMS, quel responsable du glossaire, quelle porte de relecture, avant même qu’une seule ligne de code applicatif ne suppose l’existence d’une deuxième langue.
Questions fréquentes sur les pipelines de traduction
Qu’est-ce qu’un pipeline de traduction ?
Un pipeline de traduction est le système automatisé qui extrait le nouveau contenu de votre base de code, l’achemine via un système de gestion de traduction, le fait traduire par des humains ou en MTPE, le relit en contexte et le réintègre à chaque version. Aucun passage manuel n’est nécessaire.
En quoi un pipeline de traduction diffère-t-il d’une phase de traduction ?
Une phase de traduction regroupe les traductions en fin de développement ou les répète en rattrapages ponctuels, laissant les utilisateurs attendre des semaines pour les nouvelles langues. Un pipeline fonctionne en continu : chaque version sort dans toutes les langues prises en charge à la fois, car la traduction devient une étape du build plutôt qu’un calendrier séparé.
Que signifie TMS ?
TMS signifie « translation management system », ou système de gestion de traduction : la plateforme qui achemine le contenu vers les traducteurs, applique la mémoire de traduction et les glossaires terminologiques, et suit l’avancement par langue. En logistique, les mêmes lettres désignent un transportation management system, un outil sans rapport.
En quoi un pipeline de traduction diffère-t-il de la localisation ?
Le pipeline est le mécanisme ; la localisation est l’adaptation plus large qu’il livre, incluant formats, devises et visuels. Le pipeline transporte les mots et leur statut ; la localisation détermine tout ce dont un marché donné a besoin en plus, comme les formats numériques, les dates, les devises, les symboles, les images ou certaines exigences légales (W3C).
Traduisez-vous le contenu vous-mêmes, ou construisez-vous seulement le pipeline ?
Nous organisons la traduction plutôt que de l’exécuter en interne. Grâce au pipeline que nous construisons et à notre réseau de linguistes professionnels, couvrant des dizaines de paires de langues et des centaines de traducteurs, vous bénéficiez de traduction humaine ou de MTPE à la demande pour chaque version.
Configurez le pipeline une fois, livrez toutes les langues ensuite
Indiquez-nous les langues dont votre produit a besoin et comment les nouvelles chaînes sont gérées aujourd’hui, si elles le sont. Nous concevons l’extraction, le TMS, le glossaire et la porte de relecture comme une seule construction à prix fixe, et non comme un abonnement greffé à votre base de code après le lancement.
À lire ensuite
Besoin d’un logiciel qui parle tous vos marchés dès le premier jour ?
Dites-nous ce que vous voulez faire construire. Nous répondons avec un périmètre fixe, un prix fixe et une date de livraison en semaines.