Le processus de développement logiciel, étape par étape
Le processus de développement logiciel en cinq étapes : cadrage, conception, build, recette, livraison. Ce qui se passe à chacune et quoi vérifier.
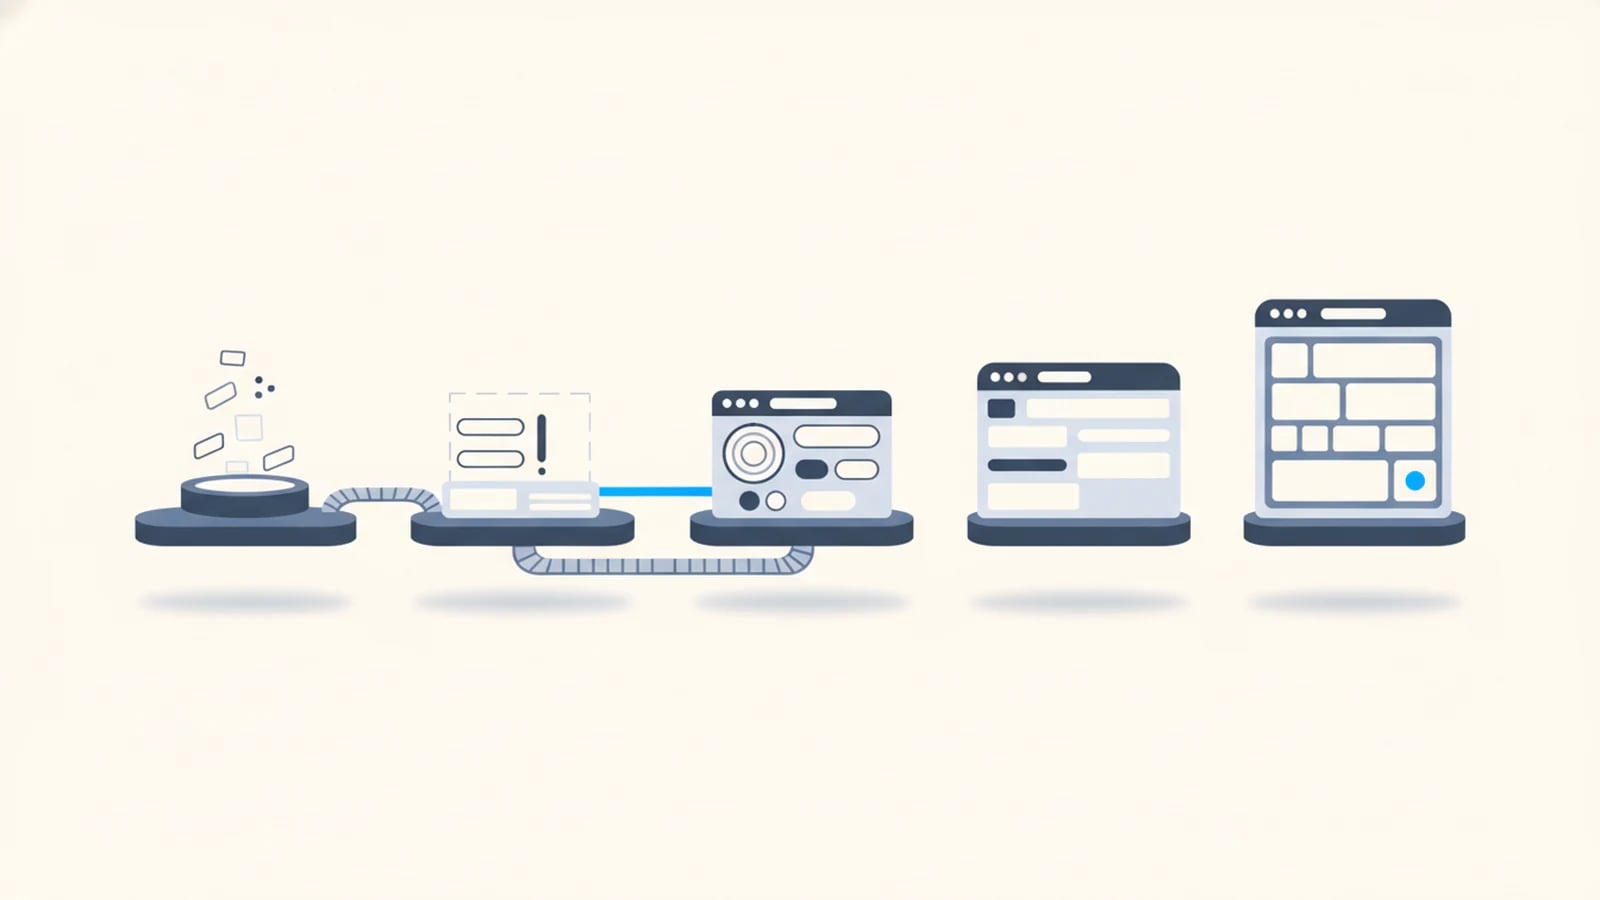
Le développement logiciel sur mesure est le parcours qui transforme une idée brute en un logiciel opérationnel dont vous êtes propriétaire. Il passe toujours par cinq étapes : cadrage, conception, build, recette et livraison. Les appellations diffèrent d’un prestataire à l’autre, mais pas la logique. Connaître cette séquence permet de distinguer un processus rigoureux d’un processus approximatif avant de signer, et de savoir où vous en êtes une fois le projet lancé.
Rédigé pour le commanditaire, pas pour le développeur. Notre guide sur le développement logiciel sur mesure aborde les coûts, les délais et la décision de construire ou d’acheter. Ici, nous détaillons la mécanique du build : ce qui se passe à chaque étape et ce que vous devez pouvoir valider avant de passer à la suivante.
Les cinq étapes incontournables d’un développement
Quelle que soit la méthode, le travail suit le cycle de vie du développement logiciel (SDLC) : une progression des exigences jusqu’à un système fonctionnel et maintenu. Les équipes agiles enchaînent ces étapes en cycles courts, tandis qu’un projet à périmètre fixe les déroule une fois, de manière linéaire. Dans les deux cas, ces activités sont généralement présentes, mais peuvent être itératives, parallèles ou regroupées. Leur omission augmente certains risques, sans pour autant être la seule cause d’un dérapage. Pour une définition complète, consultez l’entrée cycle de vie du développement logiciel.
L’importance de respecter cette séquence est un constat ancien et documenté. Dans le rapport CHAOS de 1994 du Standish Group, portant sur 365 répondants et 8 380 applications, 52,7 % des projets étaient classés « en difficulté » et 31,1 % « en échec », ces projets coûtant en moyenne 189 % de leur estimation initiale. Ce rapport historique lie les projets en difficulté à des exigences incomplètes, à un manque d’implication des utilisateurs et à des changements de spécifications. Les étapes présentées ici sont conçues pour limiter précisément ces risques.
Étape 1 : cadrage et exigences
Tout repose sur cette phase, qui transforme votre besoin en une spécification écrite. Écrans, rôles utilisateurs, règles métier, intégrations et critères d’acceptation : le tout formulé dans un langage clair, que vous pouvez lire et valider.
C’est ici que se joue la réussite ou l’échec d’un projet. Un périmètre flou (« construisez-nous un portail ») est la recette des dépassements, car chaque hypothèse non clarifiée devient une demande d’évolution coûteuse. Un périmètre précis définit ce que le logiciel fait, et surtout, ce qu’il ne fait pas. En tant que commanditaire, votre rôle est de repérer les manques tant qu’il s’agit encore d’une phrase à corriger, et non d’une fonction à réécrire. Exigez des critères d’acceptation : les conditions précises que le logiciel devra remplir. Ces critères serviront de base aux tests de l’étape quatre, et les écrire maintenant évite les conflits plus tard.
Bon signe : le prestataire pose des questions précises et inconfortables sur les cas limites (que se passe-t-il en cas de paiement partiel, d’annulation de commande, d’utilisateur avec deux rôles ?). Mauvais signe : il acquiesce et promet de « voir ça pendant le développement ».
Étape 2 : conception et architecture
Une fois le « quoi » défini, cette étape détermine le « comment ». Modèle de données, approche d’intégration, architecture de sécurité et, pour les projets internationaux, plan d’internationalisation.
La plupart de ces choix vous échappent et sont coûteux à modifier par la suite, d’où l’importance de les arrêter avant de coder. La protection des données et les exigences de sécurité doivent être intégrées dès cette phase, notamment dans les choix d’architecture et de fonctionnalités. Le modèle de données détermine ce que le logiciel peut représenter. L’approche d’intégration conditionne la fluidité avec votre ERP, votre prestataire de paiement ou vos transporteurs. Le modèle de sécurité définit qui peut voir et faire quoi. Si l’application traite des données personnelles, la conception doit prévoir la minimisation des données et des paramètres par défaut protecteurs. Enfin, si le logiciel doit un jour gérer plusieurs langues ou devises, c’est maintenant qu’il faut l’anticiper, ou s’attendre à des adaptations douloureuses plus tard. Vous ne relirez pas ces décisions en détail, mais vous devez pouvoir en comprendre la logique et en demander les raisons.
Étape 3 : build
C’est l’étape que la plupart imaginent quand on parle de « développement » : le logiciel prend forme. Chez Globaprom, nous utilisons une approche assistée par IA : les ingénieurs s’appuient sur des outils de codage automatisé, puis soumettent chaque partie du code à une relecture et à des tests. La CNIL recommande également de sécuriser l’environnement de développement et de mettre en place un versionnage du code, des pratiques qui complètent la relecture et les tests.
Pendant le build, la seule chose à exiger, c’est la transparence. Vous devez voir un logiciel qui fonctionne, pas une boîte noire qui ne s’ouvre qu’au jour J. Des points réguliers face au périmètre permettent de repérer les écarts tôt, quand ils sont encore peu coûteux à corriger. Un processus qui disparaît des semaines pour réapparaître avec un produit fini est un processus qui cache ses problèmes jusqu’à ce qu’il soit trop tard pour les résoudre sans surcoût. Pour savoir comment nous menons cette étape, notamment la relecture du code généré par IA avant livraison, consultez comment nous cadrons, construisons et relisons.
Étape 4 : recette
À ce stade, le logiciel est confronté aux critères d’acceptation définis à l’étape un. Il s’agit de la recette utilisateur (UAT) : vous, ou votre équipe, vérifiez que le logiciel correspond bien au périmètre validé, avant la mise en production. Pour plus de détails, consultez l’entrée recette utilisateur.
Les commanditaires sous-estiment cette étape plus que toute autre, alors qu’elle les protège plus que toute autre. Si l’étape un a été bien menée, la recette se déroule sans conflit : chaque critère est validé ou non, et un document permet de le vérifier. Si le cadrage était flou, c’est ici que les désaccords surgissent, au pire moment. Testez avec des scénarios réalistes, pas seulement le cas idéal : une commande bancale, un client atypique, une donnée qui sort des clous. Un logiciel qui passe une démo peut échouer un mardi. Mieux vaut le découvrir maintenant, avec le prestataire encore engagé, qu’en production.
Étape 5 : livraison et maintenance
Le build s’achève par le déploiement, la documentation, la formation et, pour un projet sur mesure, la propriété du code : le code source complet et le dépôt vous sont remis. C’est ce qui distingue la possession d’un logiciel de sa location.
Une vraie livraison inclut le code, la configuration d’infrastructure et toutes les notes nécessaires pour qu’un nouveau développeur puisse reprendre le projet, pas seulement un accès à une application fonctionnelle. Après la livraison, la maintenance devient un processus à part entière, qui doit être planifié, exécuté, contrôlé et évalué. Cela peut prendre la forme d’un forfait avec l’équipe d’origine, d’un développeur interne ou d’un autre prestataire, puisque le code vous appartient. Avant de commencer, demandez précisément ce que vous recevrez à la livraison. La réponse vous dira si vous achetez un actif ou une dépendance.
Comment l’IA accélère le délai sans changer les étapes
Le développement assisté par IA a réduit la durée de la phase de build de manière spectaculaire, sans supprimer aucune étape. Là où il fallait des mois, il suffit désormais de semaines : une automatisation de flux en deux à trois semaines, une application web complète en trois à six, une plateforme multilingue en cinq à huit, du périmètre validé à la production.
Ce qui n’a pas changé, c’est la rigueur autour du build. Le cadrage reste indispensable, car l’IA ne devine pas les exigences que vous n’avez pas formulées. La recette reste incontournable, car le code généré se teste comme tout autre. La livraison inclut toujours un code dont vous êtes propriétaire. La frappe est plus rapide, mais le jugement, l’architecture et la responsabilité restent humains. Un prestataire qui utilise l’IA pour sauter le cadrage ou la recette ne va pas plus vite : il reporte simplement le risque sur vous.
Questions fréquentes sur le processus de développement
Quelles sont les étapes d’un développement logiciel sur mesure ?
Cinq, dans cet ordre : cadrage et exigences, conception et architecture, build, recette, puis livraison et maintenance. Ensemble, elles forment le cycle de vie du développement logiciel. Les appellations varient selon les prestataires et les méthodes, mais la séquence, elle, ne change pas. Et c’est en sautant une étape que les projets dérapent.
Qu’est-ce que le cycle de vie du développement logiciel (SDLC) ?
Le cycle de vie du développement logiciel (SDLC) est la séquence complète qui mène des exigences à un système opérationnel et maintenu. Les méthodes agiles répètent ces étapes en cycles courts, tandis que les projets à périmètre fixe les déroulent une seule fois. Dans les deux cas, il couvre le cadrage, la conception, le build, les tests, le déploiement et la maintenance.
Quelle est l’étape la plus importante ?
Le cadrage et les exigences. Un périmètre flou est la première cause de dépassements et de litiges, car chaque hypothèse non clarifiée se transforme en une évolution coûteuse. Le temps passé à préciser le périmètre et à définir des critères d’acceptation clairs se rentabilise à chaque étape suivante, surtout lors de la recette.
Qu’est-ce que la recette utilisateur (UAT) ?
La recette utilisateur est l’étape où vous, le commanditaire, validez le logiciel fini par rapport aux critères d’acceptation définis lors du cadrage, avant la mise en production. Testez des scénarios réalistes, y compris les cas limites, pas seulement le parcours idéal. Des critères clairs, rédigés tôt, rendent cette étape rapide et sans conflit.
L’IA change-t-elle le processus de développement ?
Elle réduit la durée de la phase de build de plusieurs mois à quelques semaines, mais les étapes restent identiques. Le cadrage précède toujours le build, la recette le suit, et la propriété du code est toujours livrée à la fin. L’IA accélère la production du code, mais le jugement humain, l’architecture et la relecture demeurent indispensables. Sauter une étape ne fait que vous transférer le risque.
Commencez par un périmètre que vous comprenez
Décrivez-nous le processus que vous souhaitez automatiser, et nous le transformerons en un périmètre écrit, avec des critères d’acceptation que vous validerez avant toute ligne de code. Nous vous proposerons ensuite un prix fixe et une date de livraison en semaines. Si un développement sur mesure n’est pas la solution adaptée, nous vous le dirons, comme expliqué dans quand créer un logiciel sur mesure.
À lire ensuite
Besoin d’un logiciel qui parle tous vos marchés dès le premier jour ?
Dites-nous ce que vous voulez faire construire. Nous répondons avec un périmètre fixe, un prix fixe et une date de livraison en semaines.